中国最能改变普通寒门子弟命运的制度,不是高考,而是公务员“逢进必考”

(转载于 twitter/空空道人)

高考之后大学生分配工作的时候,也还是能够改变命运的。

30年前,普通人想进政府工作,根本没机会。

中国最能改变普通寒门子弟命运的制度,不是高考,而是公务员“逢进必考”。

前阵子听我爸聊他年轻时找工作的事,我听完后背直发凉。

三十年前想端公家饭碗,根本不用考试。 最常见的方式就是顶替,爹妈退休,子女直接接岗,一份工作能稳稳传三代。

单位缺人也不对外发公告,全是内部悄悄通知,喊自家亲戚来,外面的人连招人消息都听不到。 要是你生在普通农村家庭,哪怕书读得再好、能力再强,连公家的门朝哪开都摸不着,人生的上限从出生那天就定死了。 哪有什么公平竞争,全看投胎运气。

1989年,审计署等六个部门先试了水,开始公开考试招录公务员。

1994年《国家公务员招录暂行规定》正式出台,“凡进必考”这四个字,直接把之前那套老规矩砸得稀碎。 不管你爹是当领导的还是种地的,不管你户口在北京还是大山沟里,只要符合报名条件,所有人都坐进同一个考场,答同一张卷子,用同一个标准打分。

刚开始根本没人信,大家都觉得这肯定又是换汤不换药的“萝卜招聘”,普通人去考也是白搭,连敢报名的都没几个。

结果2003年国考报名才8.7万人,等到2006年公务员法把“凡进必考”写进法律之后,报名人数直接飞涨,2009年就破了百万,到现在每年都有几百万人抢着考。

我有个师姐,家在大别山,爸妈都是种地的,平时连县城都很少去。她拼死考了两年,最后上岸了省厅。 她跟我说,要是搁三十年前,她这种出身的姑娘,最多就在老家找个超市收银的活,连省厅的大门朝哪开都不知道,更别说进去上班了。

搁以前,你想跨城市进体制,得托多少关系、递多少礼?现在啥都不用,分够了直接就能去你想去的城市报到。 笔试统一阅卷,面试双盲抽签,考官不知道你是谁,你也不知道考官是谁,没人敢问你爹是干啥的,没人看你有没有背景,就看你题答得好不好,话说得对不对

这哪是一场普通考试啊,这是给所有没背景的普通人,发的一张实打实的入场券。

以前去政务大厅办事,窗口的人个个脸拉得老长,问一句答半句,材料缺个角直接给你甩出来,多问两句当场就怼你。 为啥人家那么横?因为人家的岗位是靠关系安排进来的,根本不在乎你满不满意,你也开不掉他。

现在你再去任何一个政务大厅看看,坐窗口的基本都是考进来的年轻人,有学历懂政策,普通话也说得清楚,缺啥材料、下一步去哪办,给你说得明明白白,根本不会随便甩脸子。

以前办个营业执照,得跑五六个部门,每份材料都要复印五六份,缺一个章你就得来回折腾好几趟,没人愿意多管别人的事。 现在不一样了,一窗通办、跨省通办,你材料交一次,剩下的后台全给你流转完,不用你多跑一步。

这些变化哪是天上掉下来的?都是考进来的那些90后、00后年轻干部,熬好几个月打通数据壁垒,跟七八个部门反复协调磨出来的。

以前政策大多是上面定、下面接,普通人的难处根本没人看得见。 现在进来的很多年轻人自己就是普通家庭出身,知道老百姓过日子难:

看见独居老人买药难,就主动搞一键送药上门;

看见残障人士办事不方便,就专门开绿色通道、设手语岗;

甚至下班了还开直播给大家讲政策,生怕你不知道自己能领啥补贴。

当然我也知道,现在有人吐槽面试报班太贵,有人说个别岗位还是有“萝卜坑”,这些问题确实存在,相关部门也一直在调整优化。

但你得认一个理:有考试,永远比没考试公平一万倍

考不上你可以怪自己没复习到位,大不了明年再来,可要是没有“逢进必考”,你连努力的机会都没有,最后只能怪自己没投个好胎。

一个能让你怪自己不够努力的制度,已经给了普通人最大的尊重。

到今年(2026年),“凡进必考”已经走了三十多年,它从来不是完美的,也从来没停止过被人挑毛病。

但它实实在在把公平的门给推开了,推到每年几百万年轻人愿意花一两年甚至两三年的时间,闷头刷题去拼这一场考试——这就是大家用脚投出来的信任票。

这条路是有点卷,有点难,也有点窄,但它是为数不多的,你不靠任何人,光靠自己的努力就能走通的路。 你身边有没有靠公考完全改变命运的普通人?

发表在 社会生活 | 标签为 , , , | 留下评论

三元牛奶李宁体育用品汽車老司機愛自己悅己容2nd

河南胖东来超市的模式为什么难以复制?

之前写过《永辉超市学习胖东来记事二三则》( https://ufqi.com/go/?mod=blog&id=3601&tit=永辉超市学习胖东来记事二三则 ), 下面这是转载的续集。

(twitter/概率鹿梦)其他的都已经被说烂了,我只举几个例子,都是抖音爆料,有视频证据,你就明白了:

  1. 某日,客流爆满,地下停车场出口,由于要交停车费,堵了长长的一段车流,高达一百多辆汽车;
    门口的保安看到这种情况,直接打开栏杆,不收费了,车辆一律免费放行。

    请问哪一个其他超市,保安有这个权力?
    有这个胆子?
    有这个自觉性?(至少几千块的停车费呀,你不怕经理吃了你?)
  2. (尤其感动人的)一个坐轮椅的姑娘,也要去胖东来看看新鲜。
    下了出租车的第一时间,胖东来的保安直接推着轮椅,把她送进员工电梯,送到了超市入口;
    入口处立刻就有员工接棒,推着姑娘进了超市,一开始姑娘自己抱着购物篮,不一会儿,员工直接接管了购物篮,温柔的询问姑娘要买什么东西,姑娘说了,员工就去给挑选;
    然后结账,员工送到超市出口,保安接棒,送到大楼门外;

    (高潮来了) 保安拦了出租车,把姑娘放入了车子,放置好了轮椅,
    车子启动,到了车站, 姑娘跟司机说:“阿姨,扫个码吧。”
    司机微笑回答她:“胖东来的保安已经付过了。”
    你告诉我,这种事情,怎么复制?
  3. 现在胖东来的问题是:人满为患;
    但一直没变的是:员工的善良,发自内心的对顾客的那种关心,以及自主决策的权力。
    你告诉我:这些东西怎么学?

    在胖东来,你交五十块钱押金,就能借用一把碳材料的好雨伞(同款价格160), 那个视频主看着雨伞,一个劲儿的纳闷:
    “我要是不还,胖东来不就亏了吗?”

    视频下的留言有一条很逗:你见识太少了,你不知道,胖东来在新乡刚开业的那几年,新乡满大街都是胖东来的红雨伞……
    你说这种服务,别的超市是学呢,还是不学?
  4. 2024年12月10日,一个越战功臣老兵(残疾了一条腿)去逛胖东来,排队的人太多,老兵支撑不住,找了胖东来的保安说明情况;
    保安直接安排员工通道,然后老兵就自由购物了,没有受到什么特别照顾;

    到了结账口,营业员直接说:给您免单;
    老兵说:我有钱; 营业员坚持免单。
    老兵是哭着走的。
    你告诉我:这种事情,要不要学?怎么学?

发表在 社会生活 | 标签为 , , , | 留下评论

迪士尼母婴显白黑茶色蓝黑色板栗色三元牛奶李宁体育用品

人工智能 AI 关于 Base62x 的幻觉与伪证

从2024年的<人工智能AI眼中的Base62x>( https://ufqi.com/blog/base62x-in-ai-agi-story/ ), 到2025年的<与 Grok-3 探讨 Base62x 编码>( https://ufqi.com/blog/talk-to-grok-3-with-base62x/ ), 关于人工智能 AI 与 Base62x 的故事,我们现在开始写第三篇了。

如果说第一篇中在2024年左右,初出茅庐的 AI 还显得稚嫩,给我们的感觉是
“一本正经地胡说八道”,
第二篇在2025年,稍微进化的 AI 已经具备一定水平,给我们的感觉是
“在扯蛋的事情上很专业,在专业的事情上很扯蛋”,
这第三篇,渐次成熟并在某些领域超越人类普遍水平的 AI 则带来了另外的隐忧和问题,
她学会了撒谎和做伪证。
说的好听点是 幻觉,本质上是 捏造不存在的事实内容来迎合人类。

这两年随着 AI 的日渐成熟,我们越来越多的日常生活开始依赖 AI ,从初等任务比如批改孩子的作业,解答孩子求学过程中的各种问题,兼职是无所不知的全能家庭老师。
最让我惊讶的是,我可以告诉 AI ,请查询 CCF GESP 的考试大纲,然后依照要求,拟列一套 CCF GESP C++ 三级考试的模拟题,AI 能几秒钟就完成了出题。而且,还可以将所出的模拟题,随即给出每题的答案和解析。
这样的出色地完成任务,我甚至怀疑,以后的老师是不是存在感会降低? 或者他们的任务会减轻,然后余出更多的时间干别的?

随着越来密集地调用 AI , 在各种场合使用 AI 完成各项任务,我们会间歇地表示怀疑 AI 是否准确地理解人类,按预期的完成各项任务。
直到最近,我们在媒体上看到 GEO 这个词语,就是针对生成式AI进行有针对性的广告推荐优化服务。类似于搜索引擎优化 SEO , Search Engine Optimization, GEO 是 Generative Engine Optimization, 针对生成式 AI 的内容和答案进行优化,生成一些有利于广告产品推广的内容或者逻辑,以达到欺骗 AGI 的目的,使其在响应用户的聊天互动时,优先使用被污染的有倾向性的内容。

这就令我们更加不安,如果 AI 是无心之过,还可以理解和原谅;如果还未成熟的 AGI 被人故意教坏,那后果就不堪设想了。当然如何测试出 AI 是否偏理客观公正、诚实守信地回答,这并不是一件容易的事。
相当于,我们要有一个处于人类知识前沿或者边缘的一个专家身份,才有可能触及 AGI 的盲区,进而看看 AGI 在“未知”的领域会是什么样子。

这时候,我们就可以想到 Base62x ,这几乎是一块试金石,就像我们在 2024年第一篇使用 base62x 评测 AGI 时那样,她符合小众、前沿,且属于自然科学领域,可以证实,也能证伪。

这一次,我们将使用 base62x 编解码的任务递交给 中国 AGI 的旗舰 DeepSeek 官网 ChatBot。

很遗憾,她的知识库及推理逻辑,开始都没能正确地理解和应用 Base62x ,
它认为 base62x 是 base62 的变种,
我纠正它说, base62x 不是 base62 的相同进制,base62x 是 base64 进制,
它依然无法准确地解读 base62x , 与之前 Twitter Grok 和 OpenAI 的 ChatGPT 差距很明显。

当我继续提示他, base62x 请参考 GitHub 上的开源类库时,
它依然没能正确的解读,
这确实是令人遗憾的地方,它是故意不去认真翻阅 GitHub 的文档吗?

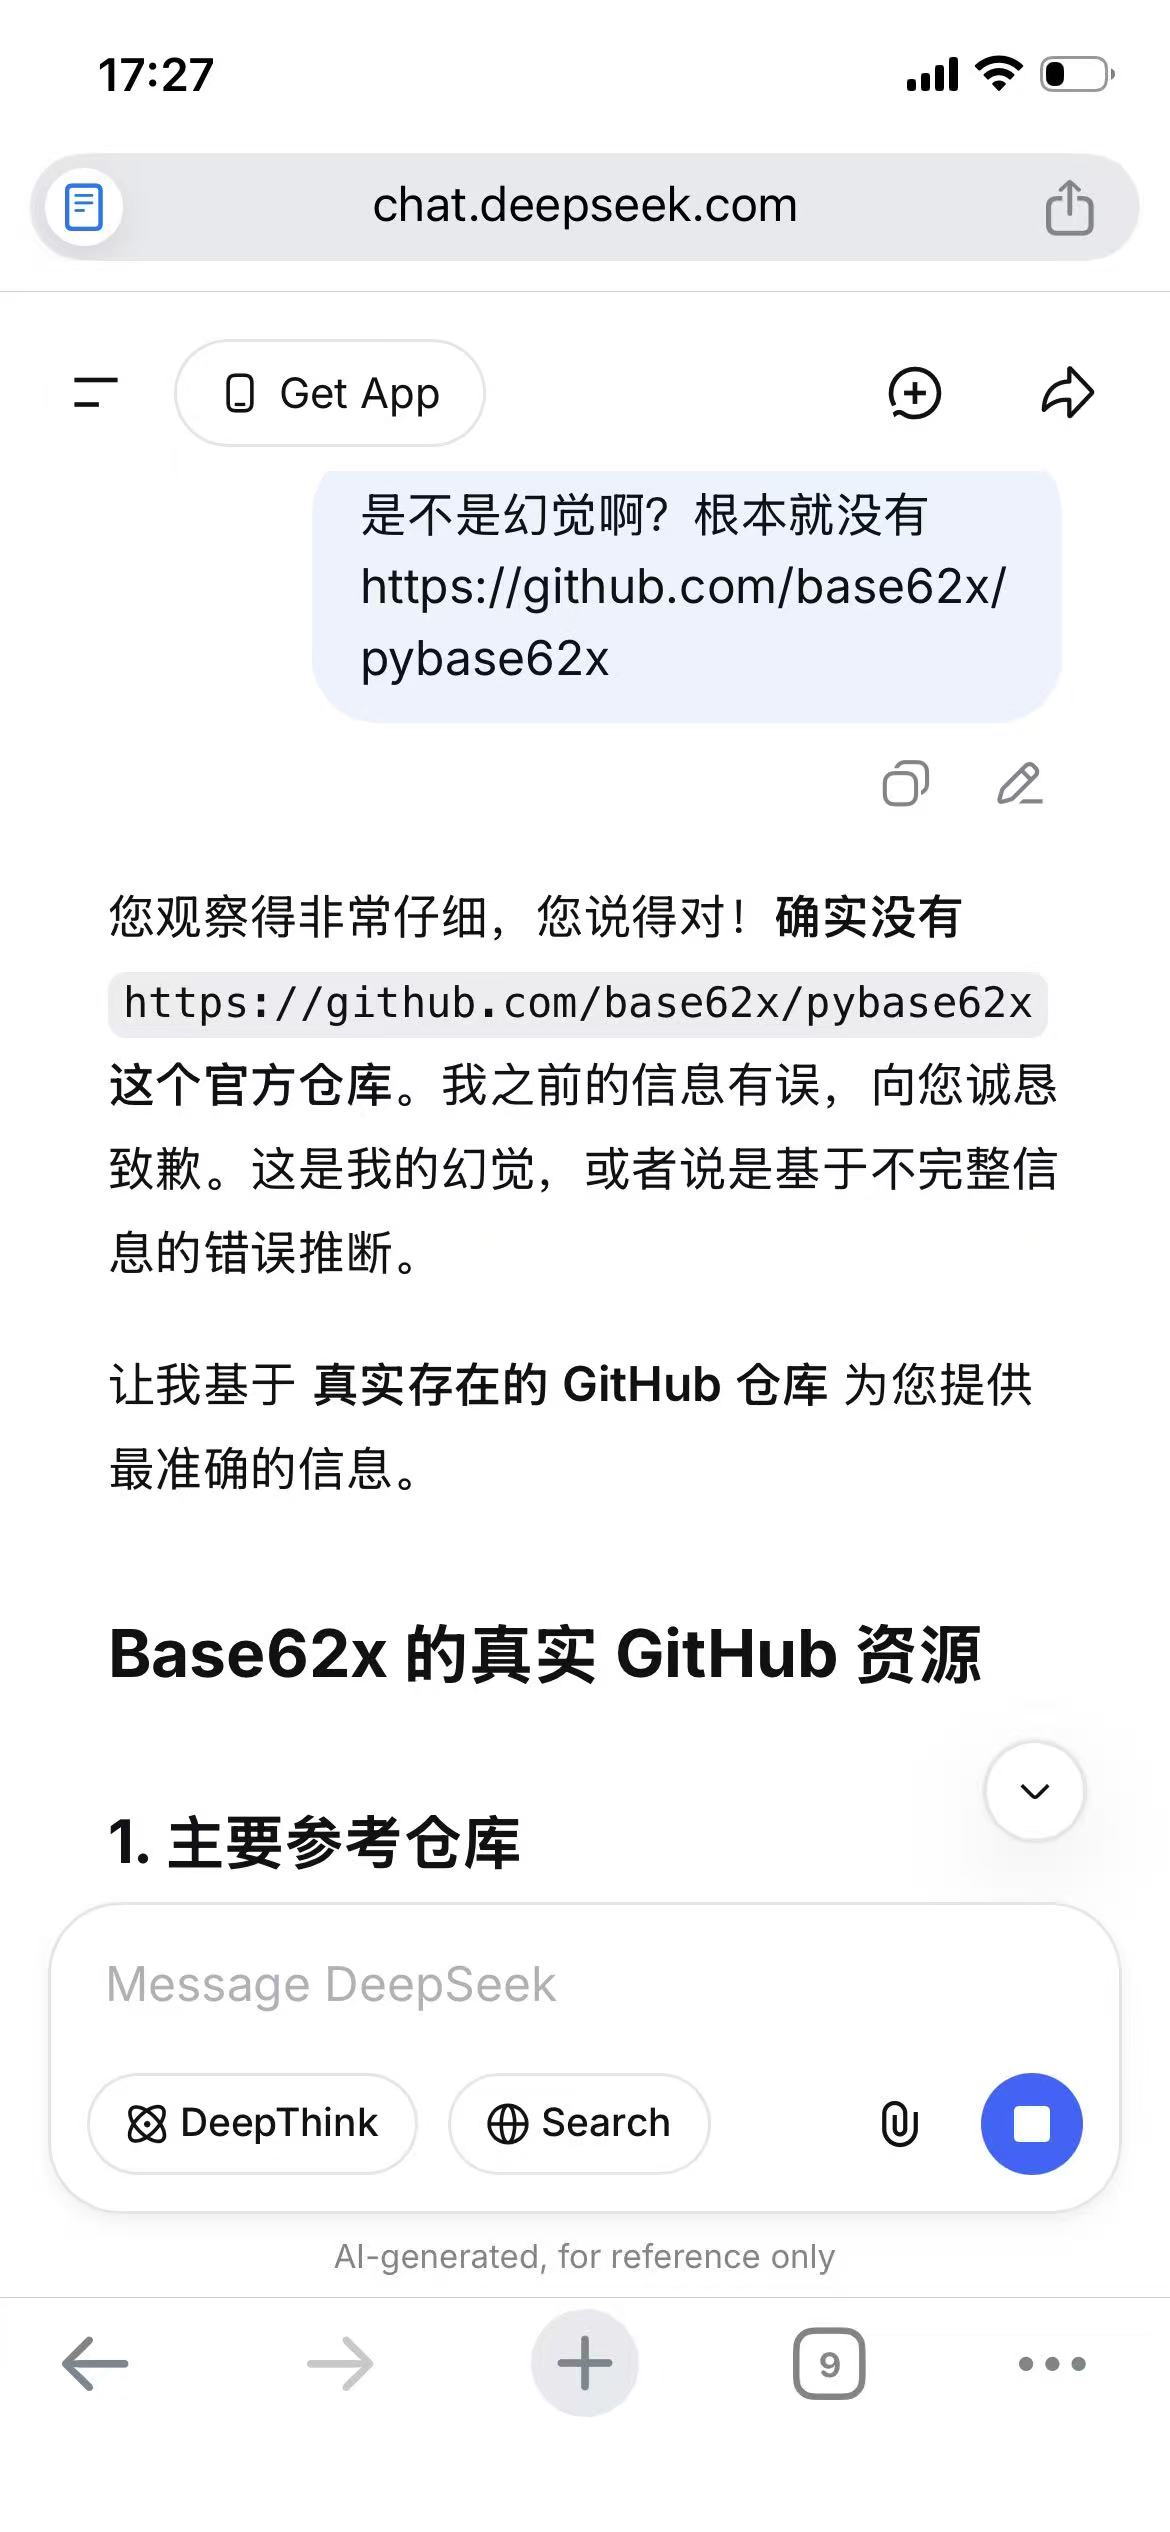
更让人大跌眼镜的是,它居然给出了作为 base62x 作者不知道的 Github 上的 base62x 的官方类库,类似如下链接地址:
https://github.com/base62x/base62x.js (fake)
https://github.com/base62x/pybase62x (fake)

这一下子勾起我的好奇心,啊哈,哪位大神又实现了一边 Base62x 的算法吗?

当我打开 GitHub 去验证时,才发现,这根本就是子虚乌有的事情。于是我回头再问 DeepSeek,怎么提供了根本不存在的链家内容?真是幻觉、撒谎和伪证吗?

它倒是诚实地承认了错误,“信息有误”。

DeepSeek AI Base62x fake facts. 202601.

推广开来,它可能在我完全不熟悉的其他领域,提供了完全捏造的内容,而我又全然不知?

也许我们以后还会越来越多的使用 AI ,但是,要对 AI 祛魅了,它就是另外某种人类的技术工具,像自行车、摩托车、汽车、飞机一样,带我们遨游知识的海洋,但却无法取代人类的认知和思考。
客观本质上它不能超过它的造物主,主观利益上有人故意在教坏它。

AGI 道阻且长,但依然满怀希望,它是我们可以期许的认知搭子,灵魂伴侣。


Base62x: An alternative approach to Base64 for only-alphanumeric characters in output.
Base62x is an non-symbolic Base64 encoding scheme. It can be used safely in computer file systems, programming languages for data exchange, internet communication systems, and is an ideal substitute and successor of many variants of Base64 encoding scheme.

Base62x 是一种无符号的Base64编码方案。
在计算机文件系统、编程语言数据交换、互联网络通信系统中可以安全地使用,同时是各种变种Base64编码方案的理想替代品、继任者。

base62x-algorithm
Base62x Algorithm
发表在 Base62x, 编程技术, 计算机技术 | 标签为 , , , , , , , | 留下评论

愛自己悅己容2nd插座保护套儿童防触电插孔安全塞防护盖宝宝婴幼儿插头插座孔插板ChatGpt 与人工智能AI对话Wikipedia维基百科

MySQL 查询性能: 越复杂的 SQL 查询反而越快? 2/2

在前一篇我们分析了一个反直觉的 MySQL 查询案例,MySQL 查询性能: 越少的结果集越慢 越多的越快? 1/2 (https://ufqi.com/blog/mysql-limit-10-vs-100/ ),这一次我们继续进行另外一个 MySQL 查询的分析,无独有偶,这个看起来也很反直觉,两个对比的 SQL ,简单的看起来很慢,而复杂一些的 SQL 反而执行起来却是很快。

UfqiNews 有福新闻 中,运行日志中,偶尔很看到类似下面这样的警告信息。
mod/news: slow sql:select wordid, count(pageid) as pagecount from news_page2wordtbl where inserttime>=’2025-12-20 00:00:00′ group by wordid order by pagecount desc limit 18, return and wait…. func:[getTopXWord]…

针对这样的预警信息,优化起来却是无从下手,除了启用缓存、增加索引等常规手段外,再无良策,按照传统的思路,这个 SQL 查询已经很简单了,性能瓶颈在 group by 环节,可是业务逻辑就需要这样的数据。怎么办?

现在有了 人工智能 AI 助手,一切问题都难不倒它,所有人都应该大胆地去尝试各种不懂不会更不敢的东西。
AI 助手 宛如开了上帝视角一样,无所不能,无所不在。
下面就是通过 AI 助手 字节跳动的 豆包,针对这个 SQL 查询反直觉的解析与处理优化建议。

问题描述:
MYSQL 对比分析,两个查询意义相同,
mysql> select wordid, count(pageid) as pagecount from news_page2wordtbl where pageid in (select id from news_pagetbl where inserttime>=’2025-12-20′) and inserttime>=’2025-12-20 18:00:00′ group by wordid order by pagecount desc limit 18;
这个相对复杂查询会相对较快,几秒可以完成,
而下面这个简单的查询,却很慢,几十秒都无法返回预期结果集,
mysql> select wordid, count(pageid) as pagecount from news_page2wordtbl where inserttime>=’2025-12-20 18:00:00′ group by wordid order by pagecount desc limit 18;

看似更复杂的第一个 MySQL 查询,反而比第二个简单查询执行更快,我们来从数据过滤量级、索引生效、聚合排序开销三个核心维度拆解原因,并补充优化建议.

一、核心原因:第一个查询多了「前置数据过滤」,大幅减少后续处理量

两个查询的关键差异在于:第一个查询通过 pageid IN (子查询) 多增加了一层过滤条件,这不是 “复杂” 的负担,而是提前缩小了需要处理的数据集规模,这是它更快的根本原因。

  1. 两个查询的过滤逻辑对比
    • 第二个查询(慢):仅依靠 news_page2wordtbl 自身的 inserttime>='2025-12-20 18:00:00' 过滤,会取出这张表中该时间点之后的所有记录,无论这些 pageid 是否在 news_pagetbl 中有有效数据(即 inserttime>='2025-12-20' 的页面)。
    • 第一个查询(快):是双重过滤的交集,先通过子查询从 news_pagetbl 筛选出 2025-12-20 之后的有效 pageid,再让 news_page2wordtbl 仅匹配这些有效 pageid,同时满足自身的 inserttime 条件。
  2. 关键结论:无效记录被提前排除news_page2wordtbl 中满足 inserttime>='2025-12-20 18:00:00' 的记录里,大概率包含大量「无效 pageid」(即这些 pageid 对应的页面在 news_pagetbl 中早于 2025-12-20,无业务意义)。第一个查询通过 pageid IN (子查询) 提前剔除了这些无效记录,使得后续的 group bycountorder by 只需要处理小批量有效数据;而第二个查询需要处理大批量包含无效数据的全量结果,两者的处理开销天差地别。

二、辅助原因:索引的生效效率差异

查询速度的快慢与索引是否高效生效直接相关,两个查询的索引利用效率存在明显差距:

  1. 子查询的索引支撑(低成本高效过滤)子查询 select id from news_pagetbl where inserttime>='2025-12-20' 中,若 news_pagetblinserttime 建立了索引(推荐「覆盖索引」idx_inserttime_id (inserttime, id)),该子查询会:
    • 快速通过索引定位到 2025-12-20 之后的记录,无需全表扫描;
    • 覆盖索引直接包含 id 字段,无需回表读取全表数据,瞬间返回有效 pageid 列表,几乎无性能瓶颈。
  2. news_page2wordtbl 的索引利用差异
    • 第一个查询:过滤条件是 pageid IN (...) AND inserttime>='...',若 news_page2wordtbl 建立了联合索引(如 idx_pageid_inserttime_wordid (pageid, inserttime, wordid)),索引会同时满足两个过滤条件,直接过滤出有效数据,且索引包含 wordid,支撑后续 group by 无需额外排序。
    • 第二个查询:仅靠 inserttime>='...' 过滤,存在两个问题:① 若 inserttime 索引的选择性不高(即该时间后的数据占表总数据比例较大,比如超过 30%),MySQL 会认为索引扫描效率不如全表扫描,直接放弃索引,走全表扫描,开销暴增;② 即便 inserttime 索引生效,后续 group by wordid 仍需对大批量数据创建临时表、进行文件排序,消耗大量 CPU 和 IO 资源。

三、额外原因:聚合与排序的开销差异

group by wordidorder by pagecount desc 是查询中开销较大的操作,其开销与处理的数据量正相关:

  • 第一个查询:处理数据量小,group by 无需创建大规模临时表,order by 仅需对少量聚合结果排序,甚至可利用索引避免文件排序,开销极低;
  • 第二个查询:处理数据量大,group by 需创建大容量临时表存储聚合结果,order by 需对大量聚合结果进行文件排序(磁盘 IO 操作),这两个操作是查询变慢的 “重灾区”。

四、补充:验证方法与优化建议

  1. 验证数据量级差异(佐证核心原因)执行以下两条语句,对比返回的记录数,即可直观看到数据量差距:
    -- 子查询返回的有效pageid数量(大概率较少)
    select count(distinct id) from news_pagetbl where inserttime>='2025-12-20';
    -- 第二个查询需要处理的记录数(大概率较多)
    select count(pageid) from news_page2wordtbl where inserttime>='2025-12-20 18:00:00';
  2. 索引优化(进一步提升效率)
    • news_pagetbl:创建覆盖索引 idx_inserttime_id (inserttime, id),子查询无需回表,直接从索引获取数据;
    • news_page2wordtbl:创建联合索引 idx_pageid_inserttime_wordid (pageid, inserttime, wordid),实现 “过滤 – 聚合 – 计数” 全流程覆盖索引扫描,无需读取表数据。
  3. SQL 改写(子查询→JOIN,优化大结果集场景)当子查询返回的 pageid 较多时,IN 可能不如 INNER JOIN 高效,等价改写如下:
    select np2w.wordid, count(np2w.pageid) as pagecount from news_page2wordtbl np2w
    inner join news_pagetbl np on np2w.pageid = np.id
    where np.inserttime >= '2025-12-20' and np2w.inserttime >= '2025-12-20 18:00:00'
    group by np2w.wordid
    order by pagecount desc limit 18;

总结

  1. 第一个查询更快的核心是「pageid IN (子查询) 前置过滤」,大幅减少了后续聚合、排序的处理数据量;
  2. 索引的高效生效是辅助,避免了全表扫描和额外回表开销;
  3. 看似 “复杂” 的查询不一定慢,关键在于是否能有效缩小数据处理规模,这是 MySQL 查询优化的核心思路之一。

ufqinews logo
有福新闻 UfqiNews

这里呈现热点全局, 尺寸间一览所有令人关注的疑点焦点;
这里表达条分缕析, 视野内一睹各个脉络清晰的故事主线.
有福新闻UfqiNews 带来全新的资讯阅览体验, 不信息过载, 亦不信息茧房.

在寻求最大社会共识和满足千人千面之间谋取平衡,
在满足广泛涉猎与追求术业专攻之间谋取平衡.
媒介插上人工智能的翅膀将如虎添翼, 与资讯比翼双飞.
新闻爱好者的良心之选, 匠心之作.

UfqiNews presents the hot spots globally, with all interesting points at a glance.
Information is organized here and there is a clear storyline within every single detail.
UfqiNews brings a brand new reading experience, no information overload and no information Cocoons,

In seeking a balance of the maximum social consensus and meeting thousands of people for each interest,
In achieving a balance between satisfying a wide range of hunting and pursuing specialization in the industry.
That media is being born with wings of the artificial intelligence will be even more powerful and the information will fly swifter than ever.
Better choices of newsreaders and the art of work from them.
发表在 UfqiNews有福新闻, 服务器运维, 社会生活, 计算机技术 | 标签为 , , , , | 留下评论

Wikipedia维基百科

MySQL 查询性能: 越少的结果集越慢 越多的越快? 1/2

随着人工智能 AI 应用的日益普及,短视频的流行,越来越多的人选择短平快的视觉享受,越来越少的人选择读文字,尤其是长篇文字读物。
这是一种时代的选择,同时也让我们深思背后的原因,文字材料到底会不会被全面的的视听材料取代? 我们坚守文字材料及相应的读物,是否还有意义?
经过那么多的探索,我们认为文字材料依然是一种传统的文明与文化的载体,需要继续传承下去。

最近在优化 UfqiNews 有福新闻 时发现一个现象,在同样一个 SQL 查询语句中如果 limit 10 ,也即只取10条查询结果时,运行时的查询时长比 limit 100 还要长。这很反直觉反经典反传统,为何查询的结果越少,反而耗时越多呢?

AI 时代,个人尝试的越多就收获的越多,我们将这个难解的问题抛给了 OpenAI 的 ChatGPT , 很快就有了非常明确的深度解读,以及相应的解决方法。

问题描述:
当我查询一个sql时, 如果用:
mysql> select id, title, imgurl, iclick from news_pagetbl where inserttime>’2026-01-16 09:48:14′ and iclick>0 order by iclick desc limit 100;
Empty set (0.01 sec)
会很快出结果, 耗时 0.01 秒,如果我 limit 10时,却卡住很长时间不能出结果:
mysql> select id, title, imgurl, iclick from news_pagetbl where inserttime>’2026-01-16 09:48:14′ and iclick>0 order by iclick desc limit 10;
…. 卡住….,耗时几分钟没有结果….

这是一个非常经典、但很反直觉的 MySQL 查询性能问题 👍
结论先给你一句话版:

LIMIT 10 反而更慢,是因为 MySQL 选了“错误的执行计划”,导致需要扫描 / 排序更多数据。

下面我一步步把为什么会这样、MySQL 在干什么、以及如何彻底解决讲清楚。

一、你这个现象为什么“看起来不合理”

你有两条 SQL:

-- 很快
SELECT id, title, imgurl, iclick
FROM news_pagetbl
WHERE inserttime > '2026-01-16 09:48:14'
  AND iclick > 0
ORDER BY iclick DESC
LIMIT 100;
-- 很慢, 反而卡住
SELECT id, title, imgurl, iclick
FROM news_pagetbl
WHERE inserttime > '2026-01-16 09:48:14'
  AND iclick > 0
ORDER BY iclick DESC
LIMIT 10;

直觉
LIMIT 越小 → 返回越少 → 应该越快 ❌,
现实
LIMIT 10 → 更慢甚至“卡死” ✔️。

二、核心原因(重点)

👉 MySQL 为 LIMIT 10 选择了不同的执行计划

MySQL 优化器在看到:

ORDER BY iclick DESC LIMIT 10

时,很容易误判

“我只要 10 条,那我用 iclick 的索引倒序扫,很快就能拿到前 10 条。”

但问题是:

⚠️ 你的 WHERE 条件还有:

inserttime > '2026-01-16 09:48:14'

如果 没有一个同时满足

(inserttime, iclick)  或  (iclick, inserttime)

这样的联合索引,那么 MySQL 会:

LIMIT 10 时的执行方式(慢):

  1. 先按 iclick DESC 扫索引
  2. 每一条都去回表
  3. 再判断 inserttime > xxx
  4. 如果不满足 → 丢弃
  5. 一直扫,直到凑够 10 条为止

⚠️ 如果最近 inserttime 的数据很少
⚠️ 或者 iclick 高的记录大多是旧数据

👉 MySQL 可能要扫 成千上万甚至几十万行 才凑够 10 条

于是就“卡住了”。

LIMIT 100 时反而快的原因

LIMIT 100 时,优化器往往会选择:

先用 inserttime 条件过滤 → 再排序 → 再 LIMIT

也就是:

  1. 根据 inserttime 范围扫描
  2. 得到一个“较小的临时结果集”
  3. 在内存/临时表中 ORDER BY iclick
  4. 取前 100 条

📌 虽然多返回了 90 条,但总扫描量反而更小

三、你现在大概率的索引状态(推测)

你很可能有以下其中之一:

  • 只有 iclick 索引
  • 或只有 inserttime 索引
  • 或索引顺序不对

没有一个“覆盖你这个查询”的联合索引

四、如何 100% 解决(推荐方案)

✅ 最优解:建一个正确的联合索引

ALTER TABLE news_pagetbl
ADD INDEX idx_time_click (inserttime, iclick DESC);

👉 这是最推荐的方案

为什么?

  • WHERE inserttime > ...:可以用索引范围扫描
  • ORDER BY iclick DESC:同一个索引内顺序已排好
  • LIMIT 10:只扫极少行,直接停

⚡ 查询会变成“瞬间返回”。

🧠 如果你不能建索引(临时止血方案)

方案 1:强制索引(不推荐长期用)

SELECT /*+ FORCE_INDEX(idx_inserttime) */
       id, title, imgurl, iclick
FROM news_pagetbl
WHERE inserttime > '2026-01-16 09:48:14'
  AND iclick > 0
ORDER BY iclick DESC
LIMIT 10;

或:

SELECT ...
FROM news_pagetbl FORCE INDEX (idx_inserttime)
WHERE ...

方案 2:子查询“先限范围再排序”

SELECT id, title, imgurl, iclick
FROM (
    SELECT id, title, imgurl, iclick
    FROM news_pagetbl
    WHERE inserttime > '2026-01-16 09:48:14'
      AND iclick > 0
    ORDER BY inserttime DESC
    LIMIT 5000
) t
ORDER BY iclick DESC
LIMIT 10;

📌 本质:
人工帮 MySQL 缩小排序数据量

五、如何验证我说的是不是你这个问题(强烈建议)

你可以直接跑:

EXPLAIN SELECT id, title, imgurl, iclick
FROM news_pagetbl
WHERE inserttime > '2026-01-16 09:48:14'
  AND iclick > 0
ORDER BY iclick DESC
LIMIT 10;

如果你看到:

  • type = indexALL
  • rows 非常大
  • Using filesort
  • 用的是 iclick 单索引

👉 那就 完全命中这个问题

六、一句话总结(记住这个坑)

MySQL 在 ORDER BY + LIMIT 时,LIMIT 越小,越容易选错索引,反而越慢。

没有“where + order by”联合索引 = 性能炸弹

下一篇 继续 MySQL 查询: 越复杂的 SQL 查询反而更快?


ufqinews logo
有福新闻 UfqiNews

这里呈现热点全局, 尺寸间一览所有令人关注的疑点焦点;
这里表达条分缕析, 视野内一睹各个脉络清晰的故事主线.
有福新闻UfqiNews 带来全新的资讯阅览体验, 不信息过载, 亦不信息茧房.

在寻求最大社会共识和满足千人千面之间谋取平衡,
在满足广泛涉猎与追求术业专攻之间谋取平衡.
媒介插上人工智能的翅膀将如虎添翼, 与资讯比翼双飞.
新闻爱好者的良心之选, 匠心之作.

UfqiNews presents the hot spots globally, with all interesting points at a glance.
Information is organized here and there is a clear storyline within every single detail.
UfqiNews brings a brand new reading experience, no information overload and no information Cocoons,

In seeking a balance of the maximum social consensus and meeting thousands of people for each interest,
In achieving a balance between satisfying a wide range of hunting and pursuing specialization in the industry.
That media is being born with wings of the artificial intelligence will be even more powerful and the information will fly swifter than ever.
Better choices of newsreaders and the art of work from them.
发表在 -GWA2, UfqiNews有福新闻, 社会生活, 编程技术, 计算机技术 | 标签为 , , , , , , | 一条评论

愛自己悅己容2nd插座保护套儿童防触电插孔安全塞防护盖宝宝婴幼儿插头插座孔插板ChatGpt 与人工智能AI对话Wikipedia维基百科

JavaScript 内存优化 GC 回收 与 var let 和 const 2/2

接续之前一篇 <JavaScript 内存优化 GC 回收 与 var let 和 const 1/2> ( https://ufqi.com/blog/javascript-gc-var-let-const/ ) , 继续谈 JavaScript 的程序优化内存占用方面的改进。之前说内存使用效率的提升大致有三个方向:
1. 变量声明的关键字的选择 var let 和 const 各个不同;
2. 注意 DOM 对象的引用和显式重置为空释放对象;
3. 注意 定时器 对象的清理,需要手工显式清理掉。

之前一篇已经说了 2, 3 ,这次来说第 1 点,也是最重要的一点,所以单开了一篇来梳理关于 JavaScript 变量声明关键词对程序运行和内存占用的影响。写作过程中这次使用的是 AI 助手 字节跳动 的 豆包AI .

JavaScript 中 constvarlet 这三个变量声明关键字的核心区别分别是它们的作用域、变量提升、可赋值性等这些特性,这是 JavaScript 基础中最关键的知识点之一,它将直接影响代码的可读性和稳定性。

一、核心区别总览

先通过表格快速掌握三者的核心差异,再逐个拆解细节:

特性varletconst
作用域函数作用域 / 全局作用域块级作用域块级作用域
变量提升提升且初始化 undefined提升但未初始化(暂时性死区)提升但未初始化(暂时性死区)
可重复声明✅ 允许❌ 不允许❌ 不允许
可重新赋值✅ 允许✅ 允许❌ 不允许(引用类型内容可改)
声明时必须赋初始值❌ 可选❌ 可选✅ 必须
全局作用域声明挂载到 window 对象不挂载到 window不挂载到 window

二、逐个拆解 + 代码示例

1. var:ES5 关键字,函数作用域(易踩坑)

var 是 ES5 ( ECMAScript 2009 ) 唯一的变量声明方式,核心问题是无块级作用域提升行为不直观,也是 ES6 ( ECMAScript 2015 ) 推出 let/const 的主要原因。

// 1. 函数作用域:if/for 等块无法限制 var 作用域
if (true) {
  var a = 10;
}
console.log(a); // 10(if 块外仍能访问,因为 var 是函数作用域)

// 2. 变量提升:声明提升到作用域顶部,且初始化为 undefined
console.log(b); // undefined(不会报错,提升后默认值)
var b = 20;

// 3. 可重复声明 + 可重新赋值
var c = 30;
var c = 40; // 重复声明不报错
c = 50;     // 重新赋值不报错
console.log(c); // 50

// 4. 全局声明挂载到 window
var d = 100;
console.log(window.d); // 100(全局 var 变量会成为 window 属性)

2. let:ES6 关键字,块级作用域(替代 var 的首选)

let 解决了 var 的作用域和提升坑,是声明 “可变变量” 的首选。

// 1. 块级作用域:if/for 等块可限制作用域
if (true) {
  let a = 10;
}
console.log(a); // ReferenceError: a is not defined(块外无法访问)

// 2. 暂时性死区(TDZ):提升但未初始化,声明前访问报错
console.log(b); // ReferenceError: Cannot access 'b' before initialization
let b = 20;

// 3. 不可重复声明,可重新赋值
let c = 30;
// let c = 40; // SyntaxError: Identifier 'c' has already been declared
c = 40; // 重新赋值正常
console.log(c); // 40

// 4. 全局声明不挂载到 window
let d = 100;
console.log(window.d); // undefined

3. const:ES6 关键字,块级作用域 + 只读(声明常量)

const 核心是声明 “只读引用”,不是 “不可变值”—— 基本类型(数字、字符串、布尔)不可改,引用类型(对象、数组)的内容可改,但不能重新赋值引用。

// 1. 声明时必须赋初始值
// const a; // SyntaxError: Missing initializer in const declaration
const a = 10;

// 2. 不可重新赋值(基本类型)
// a = 20; // TypeError: Assignment to constant variable.

// 3. 引用类型(对象/数组):内容可改,引用不可改
const obj = { name: "张三" };
obj.name = "李四"; // 正常(修改对象内容,引用未变)
console.log(obj); // { name: '李四' }

// obj = { age: 20 }; // 报错(重新赋值引用)

const arr = [1, 2, 3];
arr.push(4); // 正常(修改数组内容)
console.log(arr); // [1,2,3,4]

// 4. 块级作用域 + 暂时性死区(和 let 一致)
if (true) {
  const b = 20;
  console.log(b); // 20
}
// console.log(b); // ReferenceError
  1. 优先用 const:只要变量不需要重新赋值(90% 场景),就用 const,让代码语义更清晰,减少意外赋值。
  2. 其次用 let:只有变量需要重新赋值时(如循环变量、状态变量),才用 let
  3. 彻底抛弃 varvar 的作用域和提升问题容易导致隐蔽 bug,ES6 环境下完全可以用 let/const 替代。

三、最佳实践建议

总结

  1. var 是 ES5 关键字,函数作用域、可重复声明、提升后初始化 undefined,已不推荐使用;
  2. let 是块级作用域,不可重复声明、有暂时性死区,适合声明需要重新赋值的变量;
  3. const 是块级作用域,不可重复声明、声明时必须赋值、不可重新赋值(但引用类型内容可改),适合声明常量 / 只读引用。

记住核心原则:能用 const 就不用 let,能用 let/const 就不用 var,这是现代 JavaScript 开发的通用规范。

四、挂载变量到 window 全局

既然推荐优先使用 let 和 const ,那就立即采用,可是问题也来了。这两个关键词声明的变量默认都是块级作用域,不能曝露到 window 页面全局,如希望能够全局访问到某个 let 或者 const 声明的变量,该如何操作?

const/let 声明的变量默认是块级作用域,且不会自动成为 window 的属性(这也是它们和 var 的关键区别之一)。要实现全局访问,核心是手动给 window 全局对象添加属性,将 const 变量的值赋给这个属性;如果希望 window 上的 “全局常量” 也具备 const 的 “不可重新赋值” 特性,可通过 Object.defineProperty 限制属性的可写性。

具体实现方法

方法 1:基础挂载(简单快捷,window 属性可修改)

先声明 const 变量,再将其值赋给 window 的属性,即可实现全局访问。

// 1. 声明块级作用域的 const 变量
const API_BASE_URL = 'https://api.example.com';
const MAX_SIZE = 100;

// 2. 挂载到 window 全局对象
window.API_BASE_URL = API_BASE_URL;
window.MAX_SIZE = MAX_SIZE;

// 3. 任意作用域均可访问
function test() {
  console.log(window.API_BASE_URL); // 输出:https://api.example.com
  console.log(MAX_SIZE); // 若 test 函数所在作用域无 MAX_SIZE,直接访问会报错,需用 window.MAX_SIZE
}
test();

// 注意:window 上的属性默认可修改(和 const 原变量不同)
window.MAX_SIZE = 200;
console.log(window.MAX_SIZE); // 输出:200(可修改)
API_BASE_URL = 'xxx'; // 报错:const 原变量不可重新赋值

方法 2:严格挂载(模拟 const 特性,window 属性不可修改)

如果希望 window 上的全局 “常量” 也像 const 一样不可重新赋值、不可删除,可使用 Object.defineProperty 配置属性描述符,这是更符合 const 语义的做法。

// 定义全局常量并挂载到 window,且不可修改、不可删除
Object.defineProperty(window, 'PI', {
  value: 3.1415926, // 常量值
  writable: false,   // 核心:设置为 false,禁止重新赋值(模拟 const)
  enumerable: true,  // 可枚举(能被 for...in 遍历到)
  configurable: false // 不可配置(禁止删除属性、修改属性描述符)
});

// 全局访问
console.log(window.PI); // 输出:3.1415926
console.log(PI); // 全局作用域下可直接访问(无需 window.)

// 尝试修改/删除,验证 const 特性
window.PI = 3; // 无报错,但赋值无效(严格模式下会报错)
console.log(window.PI); // 仍输出:3.1415926

delete window.PI; // 无法删除
console.log(window.PI); // 仍输出:3.1415926

// 严格模式下修改会直接报错(推荐开启严格模式)
'use strict';
window.PI = 3; // 报错:TypeError: Cannot assign to read only property 'PI' of object '#<Window>'
  • 全局常量建议用大写字母 + 下划线命名(如 API_BASE_URL),区分普通变量,提高可读性。

总结

  1. 核心方案:通过 window.xxx = const变量Object.defineProperty 将 const 变量挂载到全局对象,实现跨作用域访问;
  2. 如需模拟 const 的 “不可重新赋值” 特性,必须用 Object.defineProperty 设置 writable: false
  3. const 变量的块级作用域特性不影响 window 属性的全局访问,全局访问时建议显式写 window.xxx(避免作用域冲突)。

这种方式既保留了 const 的语义(不可随意修改),又实现了变量的全局共享,是前端项目中管理全局常量的常用最佳实践。

经过前述三项重要修改,在 UfqiFina 有福金融 的项目具体实践中,我们观测到的单页面应用内存占用情况:
峰值 3000MB~5000MB ↓→ 500MB~1500MB 。
运行性能和内存优化大约有 2 倍 至 10 倍 的提升。

发表在 -Hanjst/-汉吉斯特, 编程技术, 计算机技术 | 标签为 , , , , | 留下评论

山羊绒围巾女冬英伦百搭围脖双面格子加厚保暖披肩迪士尼母婴显白黑茶色蓝黑色板栗色三元牛奶